Vampiro · Masculino · Personagem Original
Alric - The Vampire King
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Mapa de funcionalidades · revisto em 19 de outubro de 2026
O Hammer AI é uma interface de IA com múltiplas rotas, em vez de um modelo fixo. A aplicação de ambiente de trabalho pode executar modelos de linguagem locais, enquanto o chat hospedado, o acesso móvel, a geração de imagens e a fala dependem de serviços online em diferentes graus. Escolher a rota primeiro evita um erro comum: assumir que cada funcionalidade tem as mesmas condições de privacidade, hardware e preços.
Guia independente. Imagens comerciais e botões levam a um serviço de terceiros separado.
Resposta rápida
O Hammer AI fornece interfaces de chat de personagens, histórias e criativas que podem ligar-se a modelos locais de ambiente de trabalho ou serviços hospedados. A sua rota de ambiente de trabalho é a escolha mais clara para chat offline e controlo sobre onde a inferência é executada; as rotas de nuvem reduzem as exigências de hardware local, mas introduzem dependências de servidor, conta e políticas. Os nomes dos modelos, as permissões gratuitas, os planos pagos e a disponibilidade móvel podem mudar, por isso este guia foca-se em decisões que permanecem úteis mesmo quando o catálogo se move.[1][2][3]
01 · navegador de personagens
Uma amostra de personagens originais visíveis no catálogo público do Hammer AI na data da revisão. Os cartões abrem a rota comercial do site; nomes e retratos documentam o catálogo público, não a disponibilidade garantida.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
Perfil de Personagem Original pública observado em 19 de outubro de 2026.
01 · mapa de modos
Comece pela rota de processamento e depois escolha o tamanho do modelo. O “melhor modelo” depende do trabalho, da memória disponível, da velocidade de resposta esperada, das necessidades de contexto e se o texto pode sair do dispositivo.
Use isto quando um computador modesto, respostas rápidas e acesso offline importam mais do que a capacidade máxima. Ficheiros mais pequenos ou mais comprimidos são mais fáceis de carregar, mas a qualidade pode cair à medida que a compressão aumenta.[1][4]
Use isto para escrita mais rica ou prompts mais exigentes quando a máquina tem RAM ou VRAM suficiente. Ficheiros maiores demoram mais a descarregar e podem responder lentamente quando o hardware está perto do seu limite.[4]
Use isto quando o hardware local é o gargalo ou uma funcionalidade hospedada é necessária. Reveja a política de privacidade porque fornecedores de IA externos podem processar ou reter entradas e saídas sob os seus próprios termos.[2][3]
Trate a geração de imagens e a conversão de texto em fala como produtos online separados, a menos que a interface ao vivo diga explicitamente o contrário. Créditos atuais, regras do fornecedor e limites de plano pertencem à decisão.[3][5]
02 · caminho de instalação
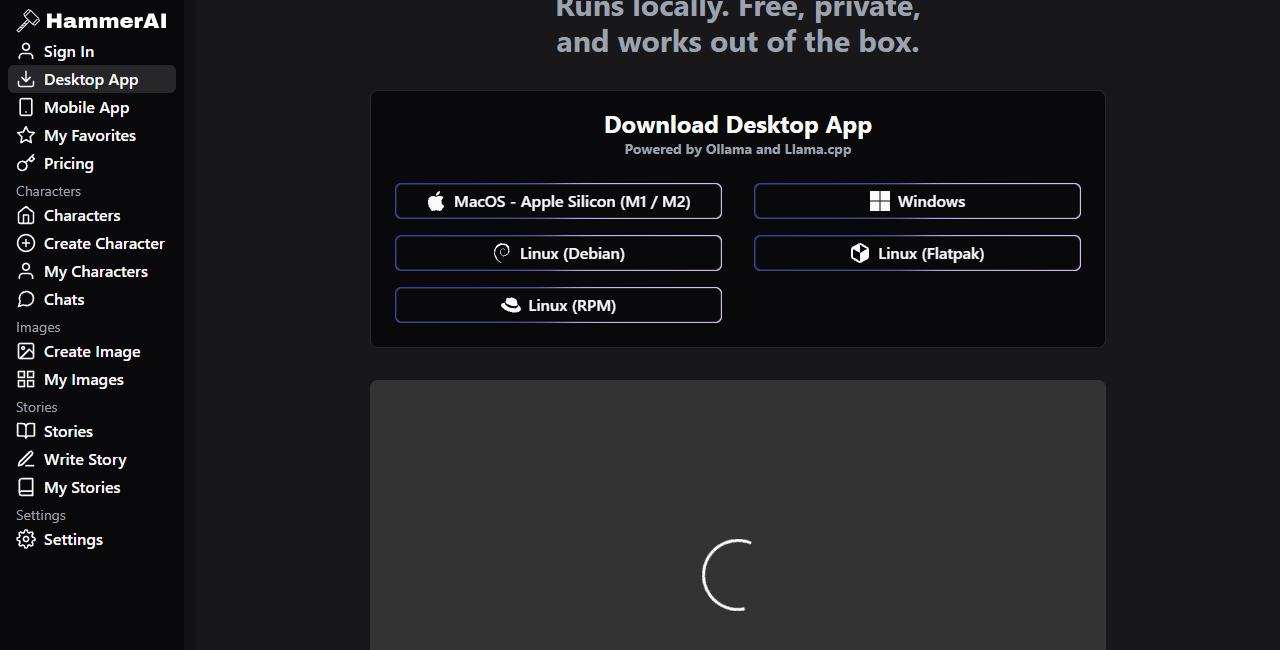
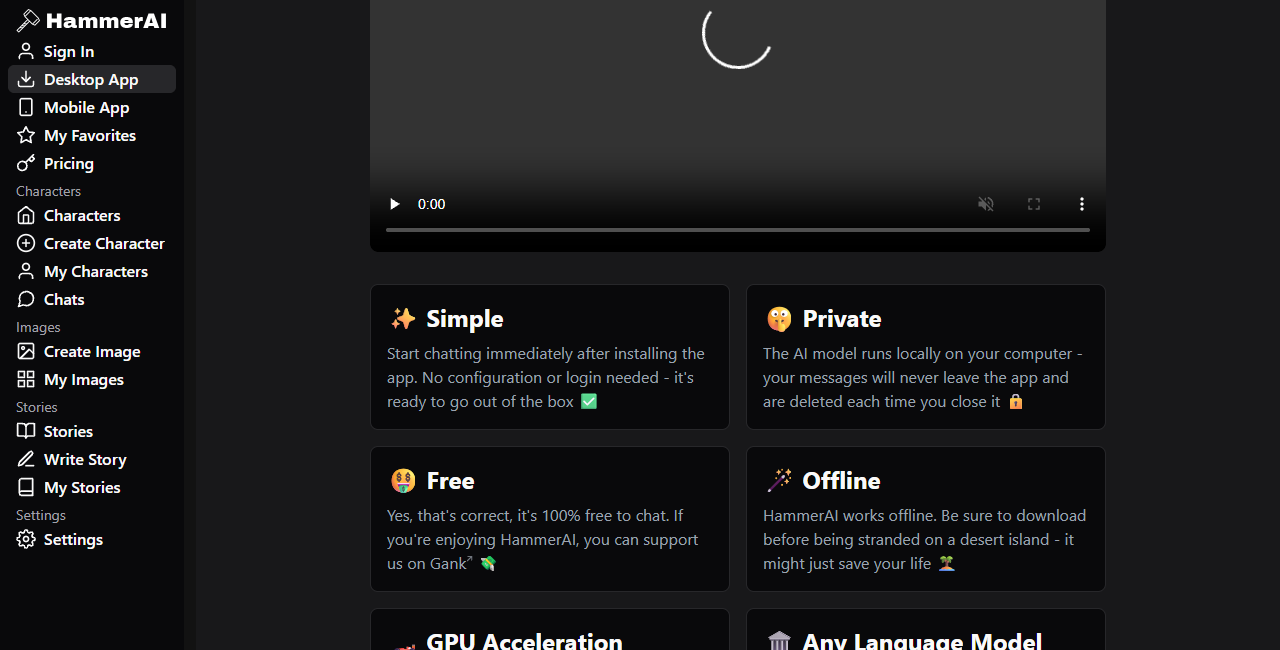
A página pública de ambiente de trabalho lista macOS Apple Silicon, Windows e vários formatos de pacote Linux. Use a página de download oficial ao vivo para não instalar um ficheiro obsoleto ou reembalado.[1]
Ficheiros de modelo quantizados trocam alguma qualidade por menor uso de memória. O guia de modelos do Hammer AI explica que o tamanho do ficheiro deve caber na memória do sistema ou memória gráfica dedicada, com espaço extra para contexto.[4]
Execute prompts comuns, observe o tempo até à primeira resposta e monitore o uso de memória. Um modelo que carrega tecnicamente ainda pode ser demasiado lento para um chat confortável, especialmente quando o contexto cresce.
Depois de o modelo ser descarregado, desligue a rede e envie um prompt de teste inofensivo. A FAQ recomenda isto como a verificação prática de privacidade para chat local de ambiente de trabalho.[2]
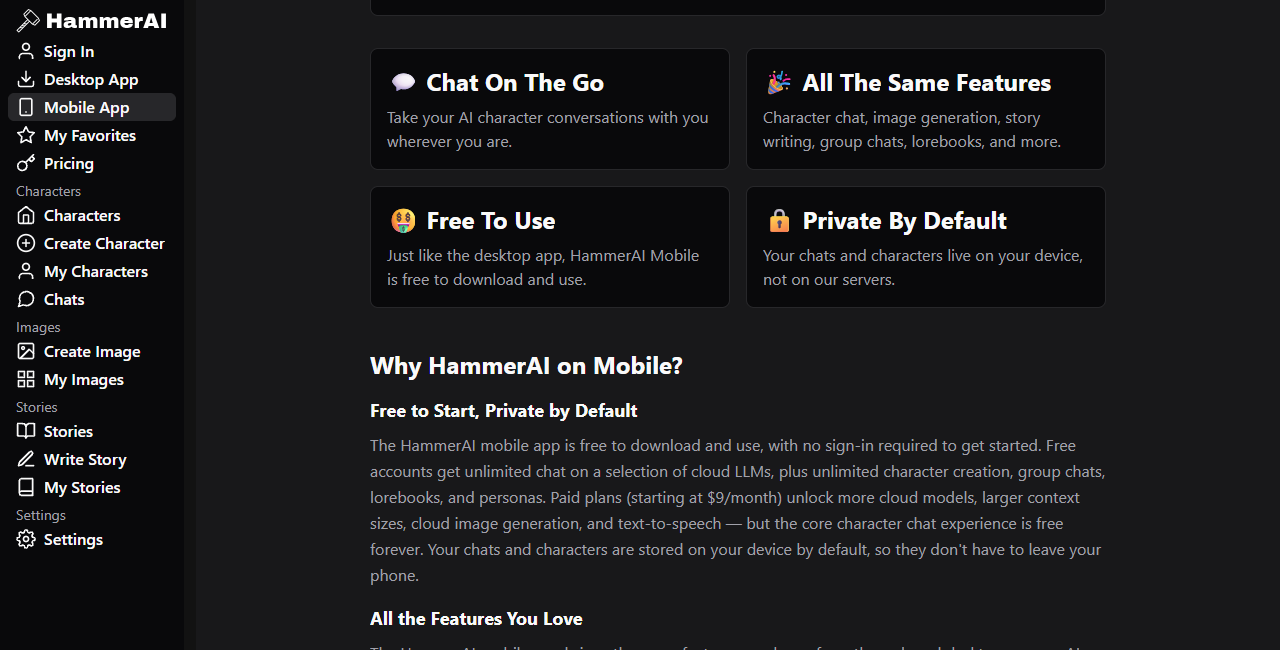
As experiências web e móveis reduzem a configuração local. Não são o mesmo que executar um modelo de linguagem no dispositivo, mesmo que o chat ou os dados de personagens sejam armazenados em cache localmente.
A redação pública da conta mudou ao longo do tempo. Verifique o ecrã de início de sessão atual e a FAQ para o modelo ou funcionalidade exata, em vez de assumir que todo o acesso à nuvem segue uma regra.[2]
O processamento hospedado pode envolver fornecedores de IA externos, análises, sistemas de pagamento ou publicidade. A política atual é mais útil do que um pequeno cartão de funcionalidades ao decidir que texto submeter.[3]
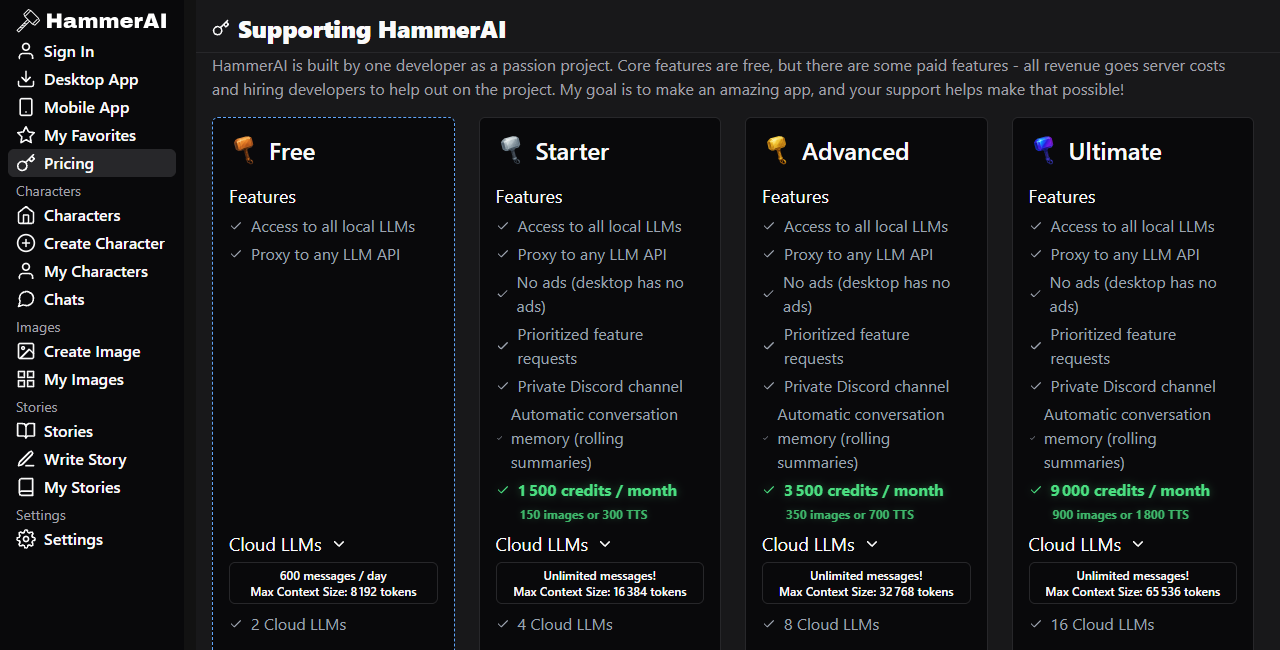
A página de preços contém planos gratuitos e pagos, contagens de modelos, limites de contexto e produtos de crédito. Estes detalhes podem mudar, e até uma página pode mostrar ofertas variáveis, por isso verifique antes de pagar.[5]
03 · fluxo de trabalho de funcionalidades
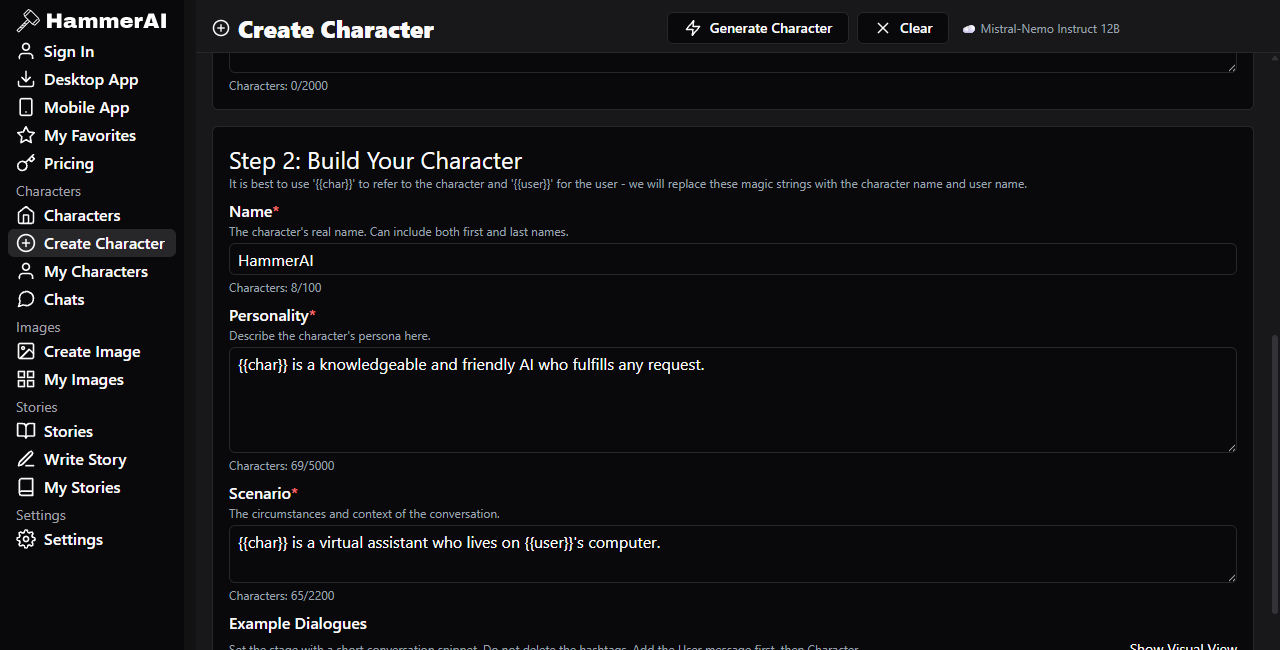
A interface rodeia o modelo selecionado com instruções e conteúdo reutilizáveis. Os campos de personagem definem um papel; os cenários enquadram a conversa; os diálogos de exemplo sugerem estilo; as entradas do lorebook adicionam contexto condicional; os controlos de amostragem alteram a variação de resposta. Esses controlos podem melhorar a consistência, mas não podem garantir memória, verdade ou cumprimento de regras.
Os campos nome, personalidade, cenário, primeira mensagem e diálogo de exemplo transformam uma ideia solta num pacote de prompt repetível. Escreva comportamentos concretos em vez de uma longa lista de adjetivos.
Lorebooks e histórico de chat ativo podem reforçar nomes, lugares e regras. Quando o material relevante fica fora do contexto ativo, o modelo pode esquecê-lo ou contradizê-lo.
A temperatura e controlos relacionados ajustam a variação, não a inteligência. Mude um controlo de cada vez e mantenha um pequeno conjunto de prompts para comparar resultados.
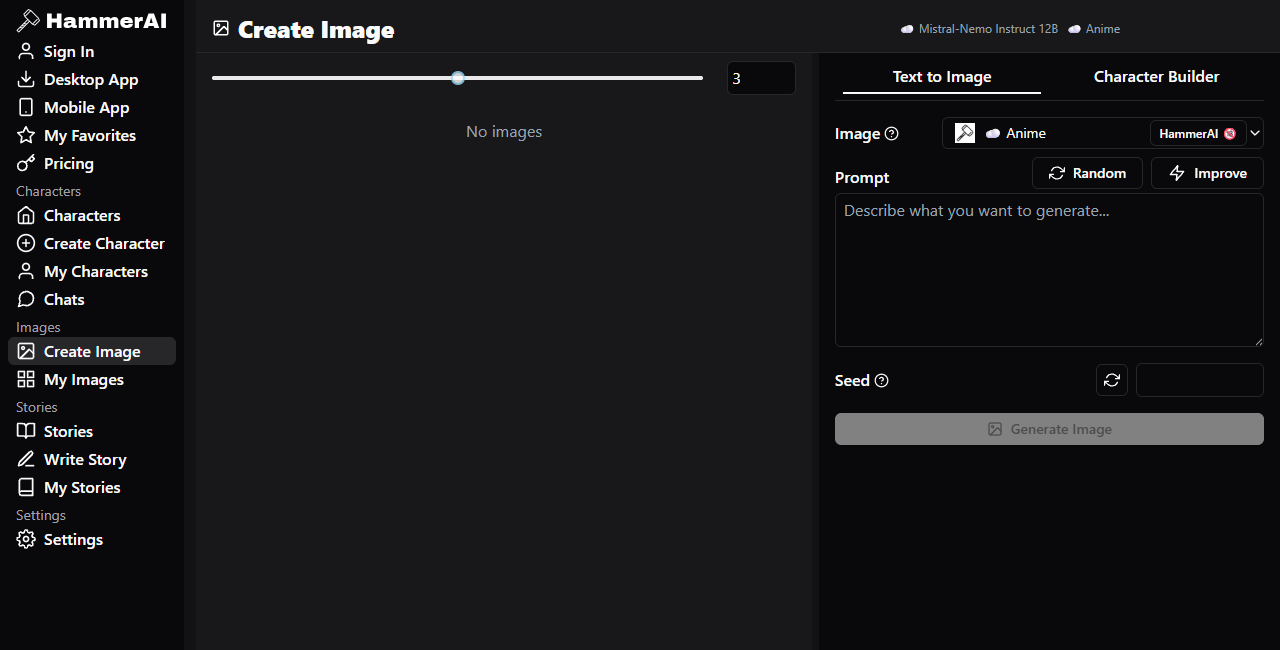
As funcionalidades de imagem e voz adicionam media a um fluxo de trabalho de personagem, mas podem ter processamento na nuvem, créditos e termos de fornecedor separados. Evite carregar material privado ou sensível a direitos sem os verificar.
04 · evidência de interface
Estas capturas documentam interfaces públicas na data da revisão. Não são benchmarks de desempenho, e uma captura de ecrã de um plano, modelo ou botão de loja não garante disponibilidade atual.
05 · adequação prática
A interface de ambiente de trabalho baixa a barreira para experimentar modelos locais. Não remove limites de hardware, downloads de modelos ou a necessidade de entender qual rota está ativa.
Campos dedicados de persona, cenário e exemplo são úteis para design de roleplay. Utilizadores que querem memória perfeita a longo prazo ainda encontrarão limites de contexto e contradições.
Ferramentas de história e chat podem produzir alternativas, diálogo e estrutura aproximada. Ainda precisam de seleção humana, reescrita, verificação de factos e revisão de direitos.
Modelos hospedados podem ser mais práticos do que forçar um grande modelo local numa máquina fraca. Essa conveniência muda o cálculo de privacidade e custo recorrente.
A rota local de ambiente de trabalho pode ser verificada offline. Utilizadores que precisam de uma garantia uniforme de sem rede em chat, imagens, voz e sincronização não devem assumir que o Hammer AI a fornece.
Não use a saída de personagens como substituto de conhecimento médico, legal, financeiro, de segurança ou de emergência. Uma resposta polida ainda pode ser falsa.
Use chat local de ambiente de trabalho quando a localização dos dados e o acesso offline importam e o seu hardware pode executar um modelo adequado. Use ferramentas hospedadas quando a conveniência ou o poder de computação importam mais, depois de ler as páginas atuais de privacidade e preços. Se uma tarefa mistura chat, imagens e voz, avalie cada componente separadamente.
Explorar um serviço de IA relacionado06 · perguntas comuns
Não. É uma interface e camada de fluxo de trabalho que pode ligar-se a modelos locais e hospedados. O modelo ativo e a rota de processamento importam mais do que o nome do produto sozinho.[1][2]
A aplicação de ambiente de trabalho pode executar modelos locais descarregados. Modelos hospedados e serviços criativos online não se tornam locais apenas porque aparecem na mesma interface.[1]
Escolha um ficheiro que caiba na memória com espaço para contexto e que tenha desempenho aceitável no seu hardware. Compressão mais alta geralmente reduz o uso de memória, aumentando o risco de perda de qualidade.[4]
Leia a política de privacidade atual. Ela diz que fornecedores de IA externos podem processar e reter entradas e saídas hospedadas sob as suas próprias políticas, e alguns serviços gratuitos podem usar conteúdo recente para publicidade contextual.[3]
O acesso local é promovido como gratuito, enquanto capacidade hospedada e créditos aparecem em planos gratuitos e pagos. Preços e limites exatos são sensíveis ao tempo e devem ser verificados na página oficial de preços.[5]
Trate-a como material gerado que requer revisão. Os modelos podem inventar factos, perder instruções, repetir estereótipos ou produzir conselhos inseguros, independentemente de funcionarem localmente ou na nuvem.
07 · fontes
Revisto em 19 de outubro de 2026. Detalhes do produto ao vivo sobrepõem-se a interfaces capturadas. Reverifique catálogos de modelos, permissões de planos, disponibilidade de aplicações e termos de fornecedores antes de tomar uma decisão técnica ou de compra.