Wampir · Mężczyzna · Oryginalna postać
Alric - The Vampire King
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Mapa funkcji · przegląd z 19 października 2026
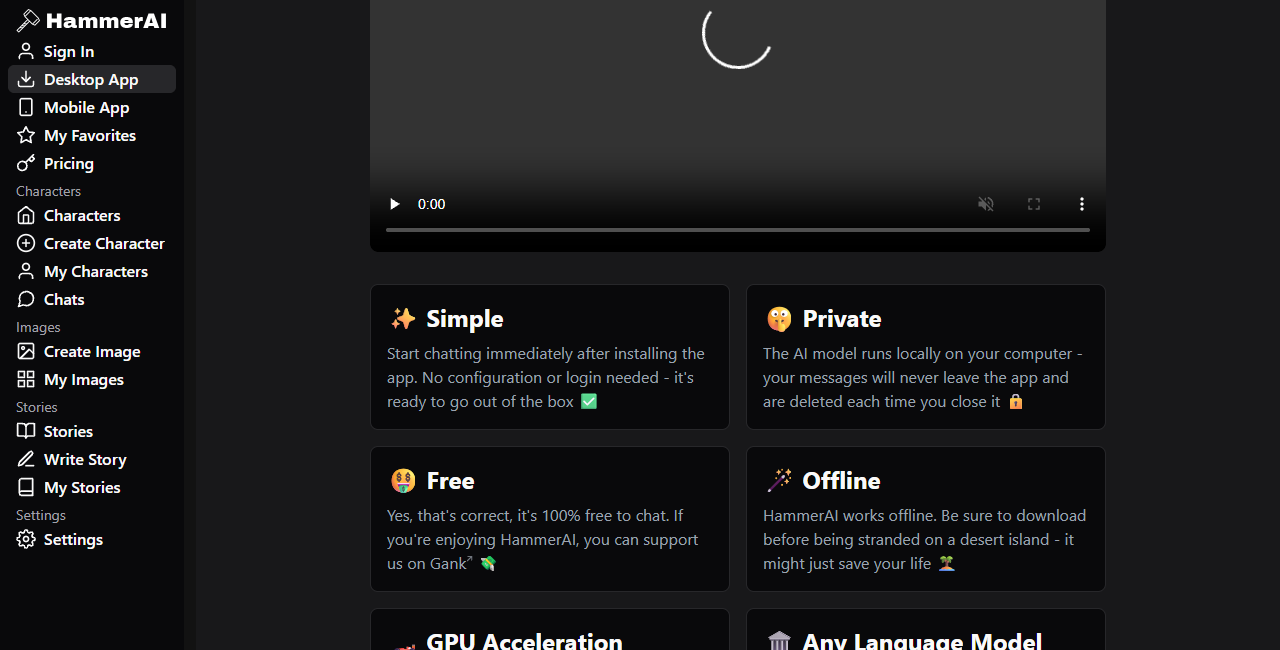
Hammer AI to interfejs AI z wieloma trasami, a nie jeden stały model. Aplikacja desktopowa może uruchamiać lokalne modele językowe, podczas gdy czat hostowany, dostęp mobilny, generowanie obrazów i mowa zależą w różnym stopniu od usług online. Wybór trasy na początku zapobiega częstemu błędowi: zakładaniu, że każda funkcja ma te same warunki prywatności, sprzętu i cen.
Niezależny przewodnik. Komercyjne obrazy i przyciski prowadzą do osobnej usługi zewnętrznej.
Szybka odpowiedź
Hammer AI zapewnia czat postaci, interfejsy do historii i kreatywne, które mogą łączyć się z lokalnymi modelami desktopowymi lub usługami hostowanymi. Trasa desktopowa jest najczystszym wyborem dla czatu offline i kontroli nad tym, gdzie działa inferencja; trasy chmurowe zmniejszają wymagania sprzętowe, ale wprowadzają zależności od serwera, konta i polityki. Nazwy modeli, bezpłatne limity, plany płatne i dostępność mobilna mogą się zmieniać, dlatego ten przewodnik skupia się na decyzjach, które pozostają przydatne nawet gdy katalog się zmienia.[1][2][3]
01 · przeglądarka postaci
Przekrój oryginalnych postaci widocznych w publicznym katalogu Hammer AI w dniu przeglądu. Karty otwierają komercyjną trasę strony; nazwy i portrety dokumentują publiczny katalog, a nie gwarantowaną dostępność.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
Publiczny profil oryginalnej postaci zaobserwowany 19 października 2026.
01 · mapa trybów
Zacznij od trasy przetwarzania, a następnie wybierz rozmiar modelu. „Najlepszy model” zależy od zadania, dostępnej pamięci, oczekiwanej szybkości odpowiedzi, potrzeb kontekstowych i tego, czy tekst może opuścić urządzenie.
Użyj tego, gdy skromny komputer, szybkie odpowiedzi i dostęp offline są ważniejsze niż maksymalna wydajność. Mniejsze lub bardziej skompresowane pliki są łatwiejsze do załadowania, ale jakość może spaść wraz ze wzrostem kompresji.[1][4]
Użyj tego do bogatszego pisania lub bardziej wymagających promptów, gdy maszyna ma wystarczającą ilość RAM lub VRAM. Większe pliki pobierają się dłużej i mogą odpowiadać wolno, gdy sprzęt jest blisko limitu.[4]
Użyj tego, gdy lokalny sprzęt jest wąskim gardłem lub wymagana jest funkcja hostowana. Sprawdź politykę prywatności, ponieważ zewnętrzni dostawcy AI mogą przetwarzać lub przechowywać dane wejściowe i wyjściowe na własnych warunkach.[2][3]
Traktuj generowanie obrazów i zamianę tekstu na mowę jako osobne produkty online, chyba że interfejs wyraźnie mówi inaczej. Aktualne kredyty, zasady dostawcy i limity planów powinny być częścią decyzji.[3][5]
02 · ścieżka instalacji
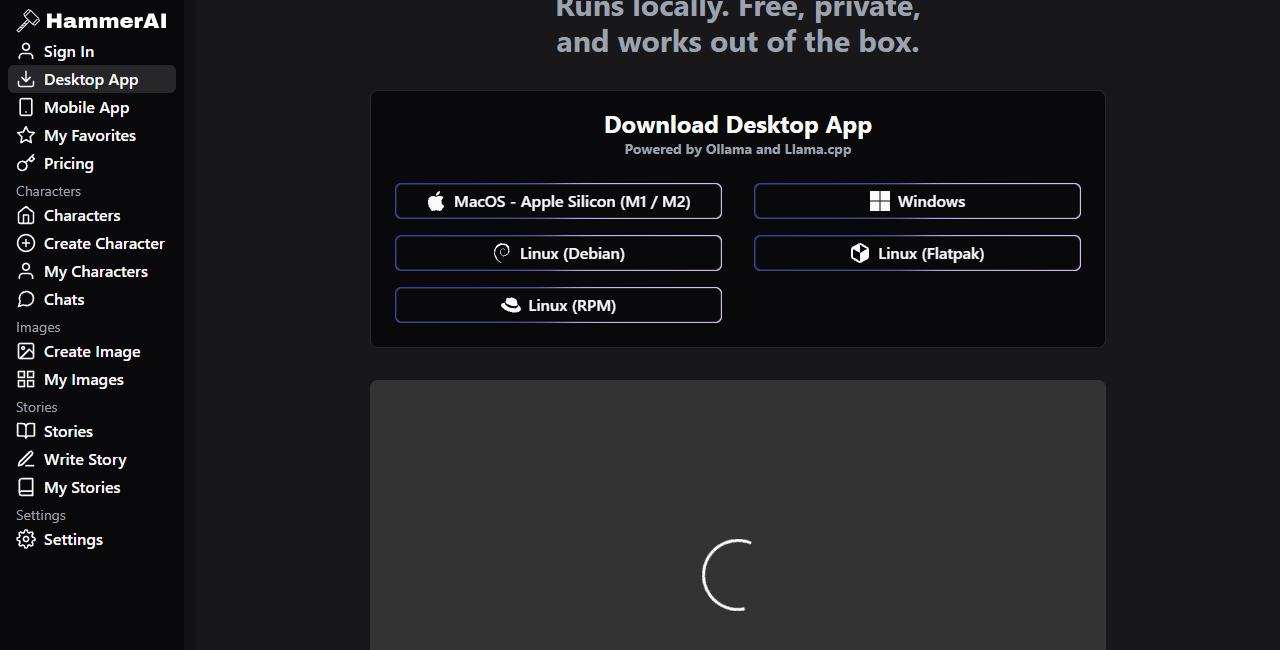
Publiczna strona desktopowa wymienia Apple Silicon macOS, Windows i kilka formatów pakietów Linux. Użyj aktualnej oficjalnej strony pobierania, aby nie zainstalować przestarzałego lub przepakowanego pliku.[1]
Skwantyzowane pliki modeli poświęcają część jakości na rzecz mniejszego zużycia pamięci. Przewodnik po modelach Hammer AI wyjaśnia, że rozmiar pliku musi mieścić się w dostępnej pamięci systemowej lub dedykowanej pamięci graficznej, z dodatkowym miejscem na kontekst.[4]
Uruchamiaj zwykłe prompty, notuj czas do pierwszej odpowiedzi i obserwuj zużycie pamięci. Model, który technicznie się ładuje, może być zbyt wolny do wygodnego czatu, zwłaszcza gdy kontekst rośnie.
Po pobraniu modelu odłącz sieć i wyślij nieszkodliwy prompt testowy. FAQ zaleca to jako praktyczną kontrolę prywatności dla lokalnego czatu desktopowego.[2]
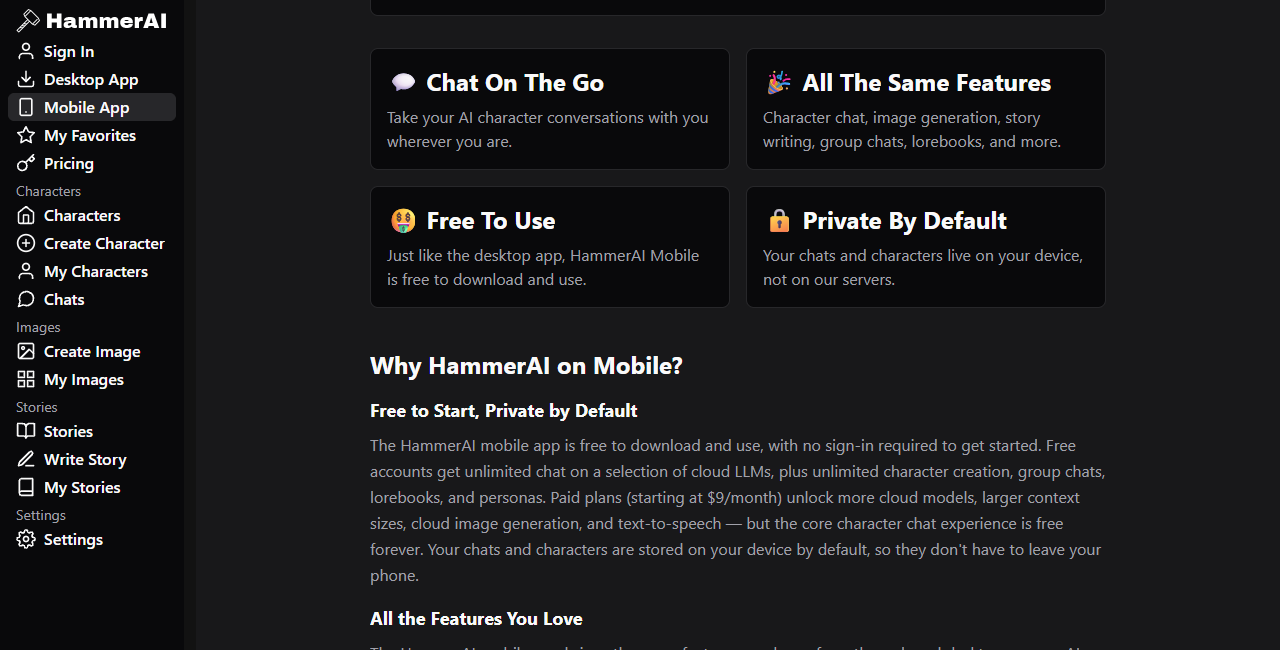
Doświadczenia webowe i mobilne zmniejszają lokalną konfigurację. Nie są tym samym co uruchamianie modelu językowego na urządzeniu, nawet jeśli czat lub dane postaci są buforowane lokalnie.
Publiczne sformułowania dotyczące kont zmieniały się z czasem. Sprawdź aktualny ekran logowania i FAQ, aby poznać dokładny model lub funkcję, zamiast zakładać, że cały dostęp chmurowy podlega jednej zasadzie.[2]
Przetwarzanie hostowane może obejmować zewnętrznych dostawców AI, analitykę, systemy płatności lub reklamy. Aktualna polityka jest bardziej przydatna niż krótka karta funkcji przy podejmowaniu decyzji, jaki tekst wysłać.[3]
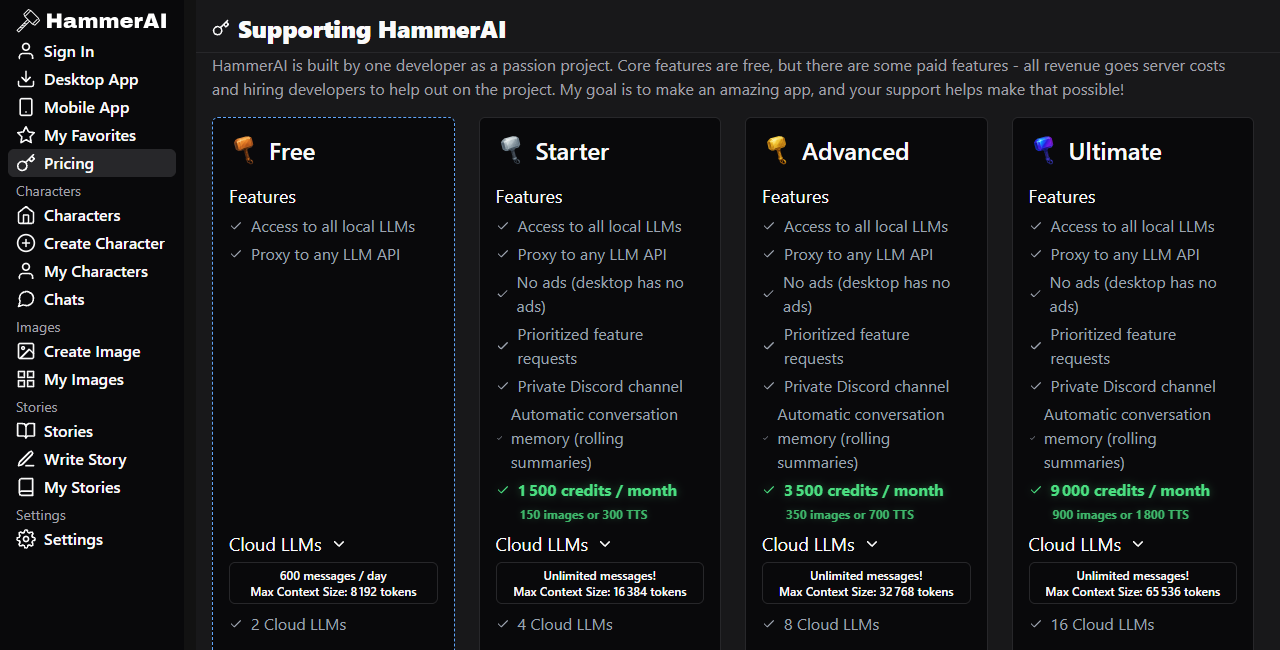
Strona cenowa zawiera plany bezpłatne i płatne, liczbę modeli, limity kontekstu i produkty kredytowe. Te szczegóły mogą się zmieniać, a nawet jedna strona może wyświetlać zmienne oferty, więc zweryfikuj przed zapłatą.[5]
03 · przepływ pracy funkcji
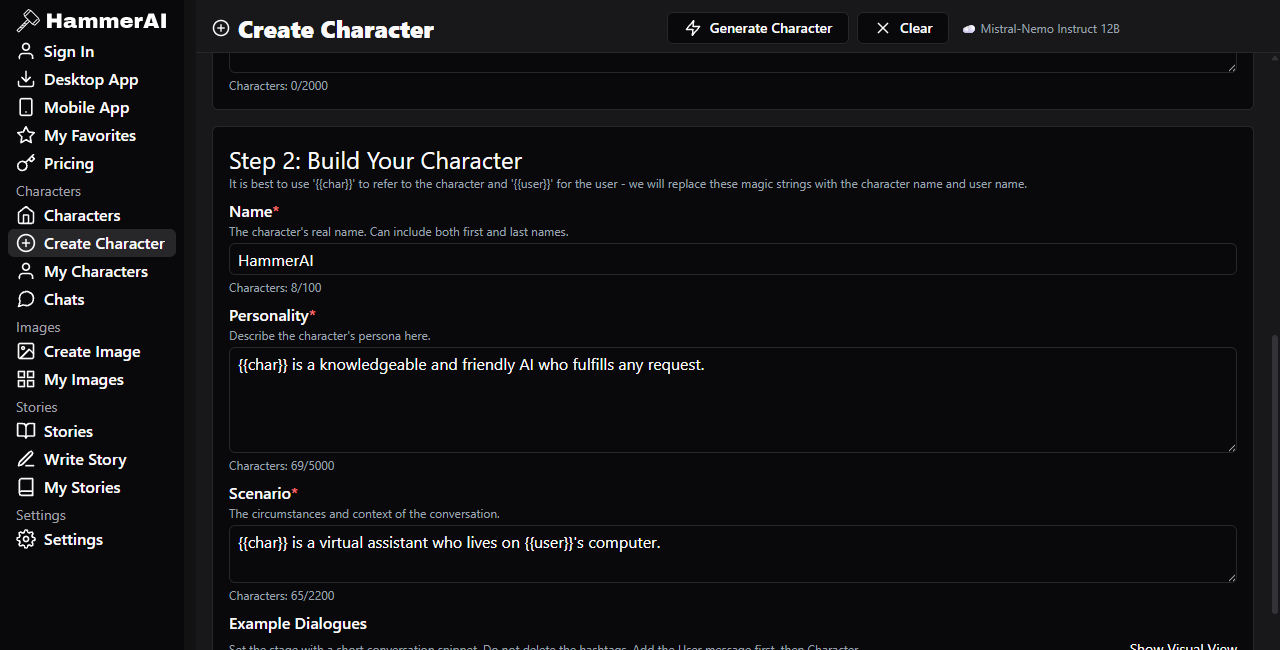
Interfejs otacza wybrany model wielokrotnego użytku instrukcjami i treścią. Pola postaci definiują rolę; scenariusze ramują rozmowę; przykładowe dialogi sugerują styl; wpisy lorebook dodają warunkowy kontekst; kontrolki próbkowania zmieniają zmienność odpowiedzi. Te kontrolki mogą poprawić spójność, ale nie gwarantują pamięci, prawdy ani przestrzegania zasad.
Pola nazwy, osobowości, scenariusza, pierwszej wiadomości i przykładowego dialogu zamieniają luźny pomysł w powtarzalny pakiet promptów. Pisz konkretne zachowania, a nie długą listę przymiotników.
Lorebooki i aktywna historia czatu mogą wzmacniać nazwy, miejsca i zasady. Gdy istotny materiał wypadnie z aktywnego kontekstu, model może o nim zapomnieć lub mu zaprzeczyć.
Temperatura i powiązane kontrolki regulują zmienność, a nie inteligencję. Zmieniaj jedną kontrolkę na raz i trzymaj mały zestaw promptów do porównywania wyników.
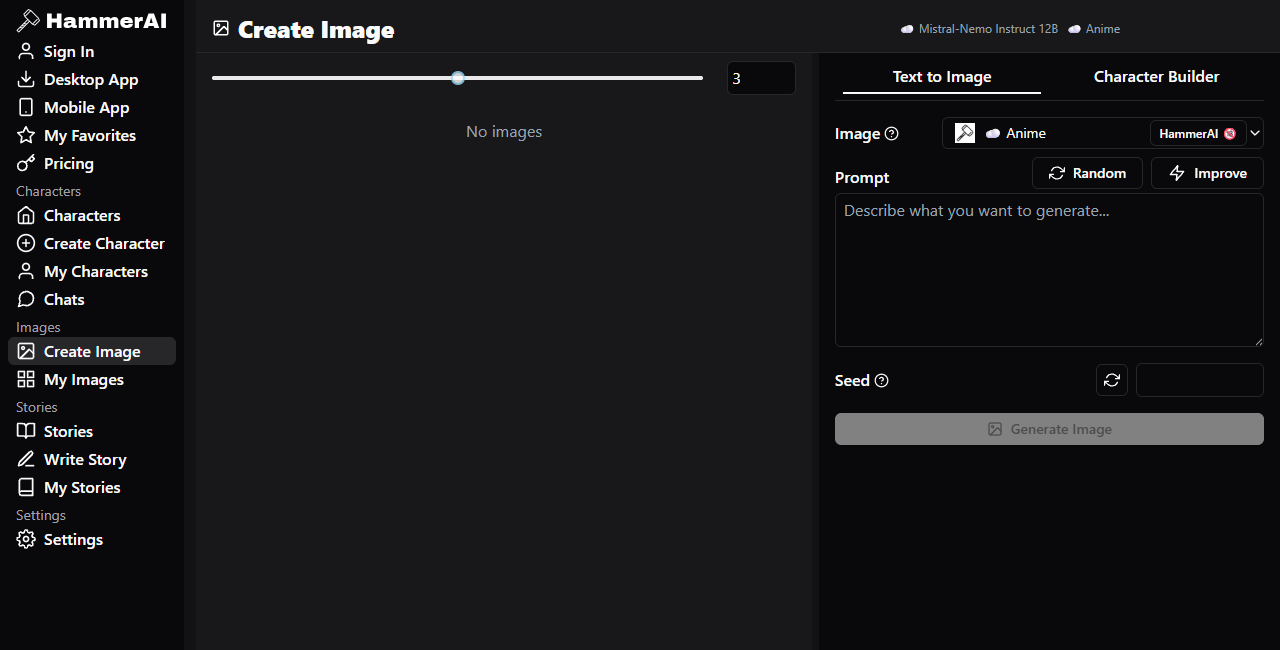
Funkcje obrazu i głosu dodają multimedia do przepływu pracy postaci, ale mogą mieć oddzielne przetwarzanie chmurowe, kredyty i warunki dostawcy. Unikaj przesyłania prywatnych lub wrażliwych materiałów bez ich sprawdzenia.
04 · dowody z interfejsu
Te zrzuty dokumentują publiczne interfejsy w dniu przeglądu. Nie są benchmarkami wydajności, a zrzut ekranu planu, modelu lub przycisku sklepu nie gwarantuje aktualnej dostępności.
05 · praktyczne dopasowanie
Interfejs desktopowy obniża barierę wejścia do lokalnych modeli. Nie usuwa jednak ograniczeń sprzętowych, pobierania modeli ani potrzeby zrozumienia, która trasa jest aktywna.
Dedykowane pola persony, scenariusza i przykładów są przydatne do projektowania ról. Użytkownicy pragnący idealnej długoterminowej pamięci nadal napotkają limity kontekstu i sprzeczności.
Narzędzia do historii i czatu mogą generować alternatywy, dialogi i zarysy. Nadal wymagają ludzkiej selekcji, przepisywania, sprawdzania faktów i przeglądu praw.
Modele hostowane mogą być bardziej praktyczne niż wymuszanie dużego lokalnego modelu na słabej maszynie. Ta wygoda zmienia kalkulację prywatności i kosztów cyklicznych.
Lokalna trasa desktopowa może być zweryfikowana offline. Użytkownicy potrzebujący jednolitej gwarancji braku sieci dla czatu, obrazów, głosu i synchronizacji nie powinni zakładać, że Hammer AI ją zapewnia.
Nie używaj wyników postaci jako substytutu wiedzy medycznej, prawnej, finansowej, bezpieczeństwa lub ratunkowej. Wypolerowana odpowiedź może być fałszywa.
Używaj lokalnego czatu desktopowego, gdy lokalizacja danych i dostęp offline mają znaczenie, a Twój sprzęt może uruchomić odpowiedni model. Używaj narzędzi hostowanych, gdy wygoda lub moc obliczeniowa są ważniejsze, po przeczytaniu aktualnych stron prywatności i cen. Jeśli zadanie miesza czat, obrazy i głos, oceń każdy komponent osobno.
Poznaj powiązaną usługę AI06 · częste pytania
Nie. To warstwa interfejsu i przepływu pracy, która może łączyć się z modelami lokalnymi i hostowanymi. Aktywny model i trasa przetwarzania mają większe znaczenie niż sama nazwa produktu.[1][2]
Aplikacja desktopowa może uruchamiać pobrane modele lokalne. Modele hostowane i internetowe usługi kreatywne nie stają się lokalne tylko dlatego, że pojawiają się w tym samym interfejsie.[1]
Wybierz plik, który mieści się w pamięci z zapasem na kontekst i działa akceptowalnie na Twoim sprzęcie. Wyższa kompresja zwykle zmniejsza zużycie pamięci, zwiększając ryzyko utraty jakości.[4]
Przeczytaj aktualną politykę prywatności. Mówi ona, że zewnętrzni dostawcy AI mogą przetwarzać i przechowywać hostowane dane wejściowe i wyjściowe na własnych zasadach, a niektóre bezpłatne usługi mogą używać ostatnich treści do reklam kontekstowych.[3]
Dostęp lokalny jest promowany jako bezpłatny, podczas gdy hostowana pojemność i kredyty pojawiają się w planach bezpłatnych i płatnych. Dokładne ceny i limity są wrażliwe na czas i należy je sprawdzić na oficjalnej stronie cenowej.[5]
Traktuj je jako wygenerowany materiał wymagający przeglądu. Modele mogą zmyślać fakty, gubić instrukcje, powtarzać stereotypy lub produkować niebezpieczne porady, niezależnie od tego, czy działają lokalnie, czy w chmurze.
07 · źródła
Przegląd z 19 października 2026. Aktualne szczegóły produktu mają pierwszeństwo przed przechwyconymi interfejsami. Sprawdź ponownie katalogi modeli, limity planów, dostępność aplikacji i warunki dostawcy przed podjęciem decyzji technicznej lub zakupowej.