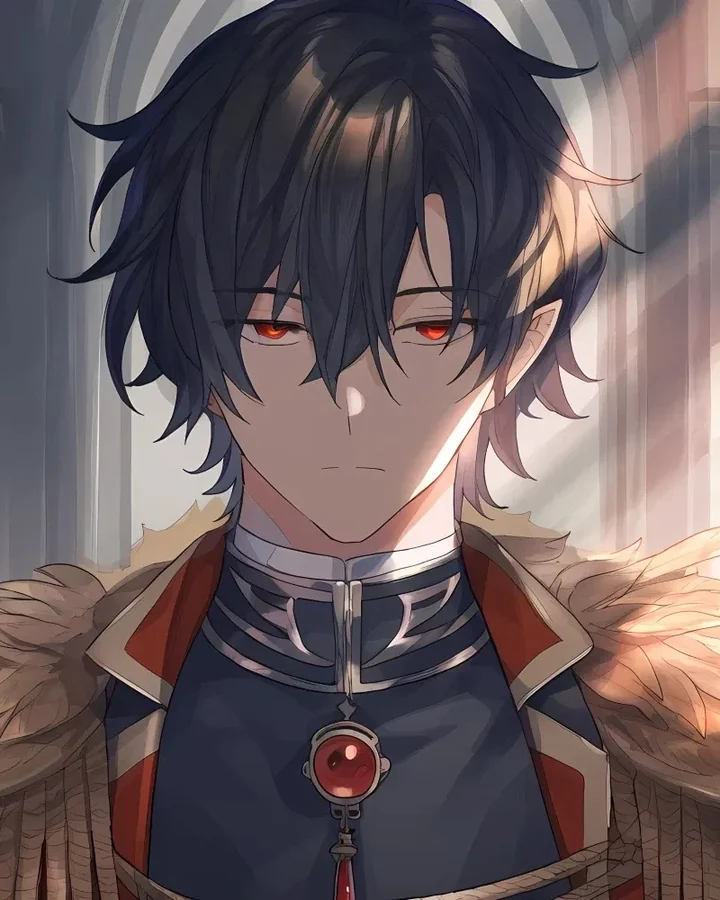
Vampire · Homme · Personnage original
Alric - The Vampire King
Profil de personnage original public observé le 19 octobre 2026.
Carte des fonctionnalités · examinée le 19 octobre 2026
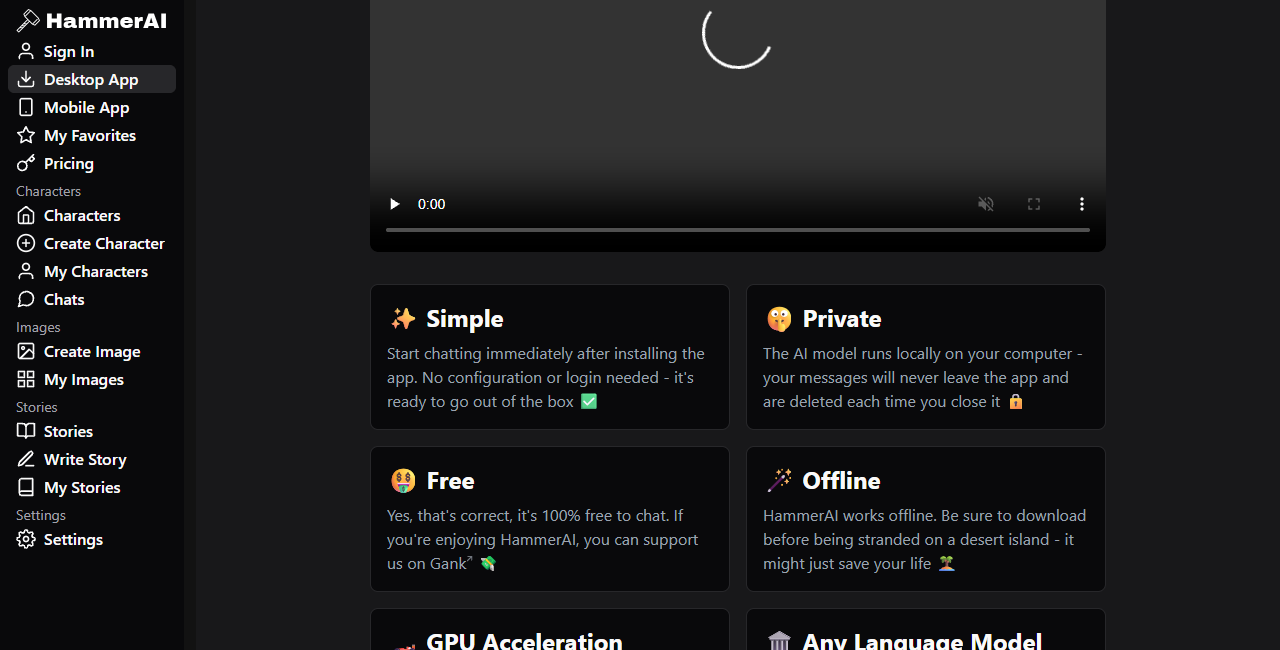
Hammer AI est une interface IA multi-itinéraires plutôt qu'un modèle fixe. L'application de bureau peut exécuter des modèles de langage locaux, tandis que le chat hébergé, l'accès mobile, la génération d'images et la parole dépendent de services en ligne à des degrés divers. Choisir d'abord l'itinéraire évite une erreur courante : supposer que chaque fonctionnalité a les mêmes conditions de confidentialité, de matériel et de tarification.
Guide indépendant. Les images commerciales et les boutons mènent à un service tiers séparé.
Réponse rapide
Hammer AI fournit des interfaces de chat de personnages, d'histoires et de création qui peuvent se connecter à des modèles de bureau locaux ou à des services hébergés. Son itinéraire de bureau est le choix le plus clair pour un chat capable hors ligne et un contrôle sur l'endroit où l'inférence s'exécute ; les itinéraires cloud réduisent les exigences matérielles locales mais introduisent des dépendances au serveur, au compte et à la politique. Les noms de modèles, les allocations gratuites, les plans payants et la disponibilité mobile peuvent changer, donc ce guide se concentre sur les décisions qui restent utiles même lorsque le catalogue évolue.[1][2][3]
01 · navigateur de personnages
Un échantillon de personnages originaux visibles dans le catalogue public Hammer AI à la date de l'examen. Les cartes ouvrent l'itinéraire commercial du site ; les noms et portraits documentent le catalogue public plutôt qu'une disponibilité garantie.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
Profil de personnage original public observé le 19 octobre 2026.
01 · carte des modes
Commencez par l'itinéraire de traitement, puis choisissez une taille de modèle. Le « meilleur modèle » dépend de la tâche, de la mémoire disponible, de la vitesse de réponse attendue, des besoins de contexte et de la possibilité que le texte quitte l'appareil.
Utilisez ceci lorsqu'un ordinateur modeste, des réponses rapides et un accès hors ligne importent plus que la capacité maximale. Les fichiers plus petits ou plus compressés sont plus faciles à charger, mais la qualité peut diminuer à mesure que la compression augmente.[1][4]
Utilisez ceci pour une écriture plus riche ou des invites plus exigeantes lorsque la machine a suffisamment de RAM ou de VRAM. Les fichiers plus grands prennent plus de temps à télécharger et peuvent répondre lentement lorsque le matériel est proche de sa limite.[4]
Utilisez ceci lorsque le matériel local est le goulot d'étranglement ou qu'une fonctionnalité hébergée est requise. Examinez la politique de confidentialité car les fournisseurs d'IA externes peuvent traiter ou conserver les entrées et sorties selon leurs propres conditions.[2][3]
Traitez la génération d'images et la synthèse vocale comme des produits en ligne séparés, sauf si l'interface en direct indique explicitement le contraire. Les crédits actuels, les règles du fournisseur et les limites du plan doivent être pris en compte dans la décision.[3][5]
02 · chemin d'installation
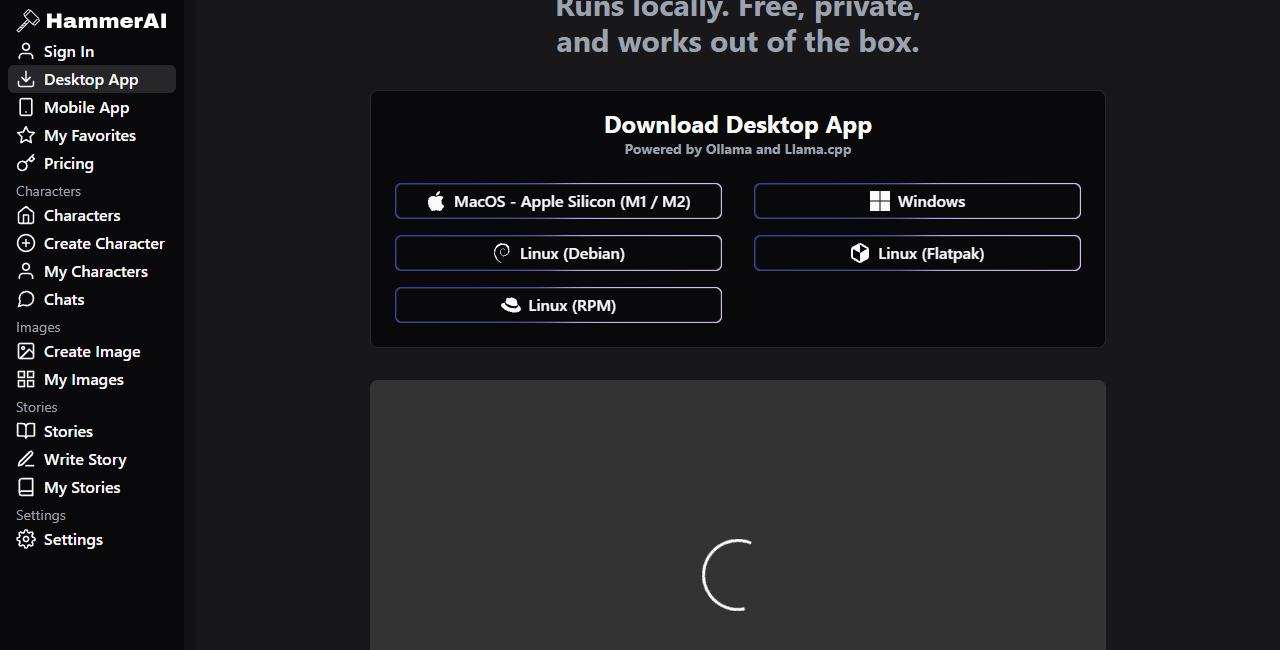
La page de bureau publique répertorie macOS Apple Silicon, Windows et plusieurs formats de paquets Linux. Utilisez la page de téléchargement officielle en direct pour ne pas installer un fichier obsolète ou reconditionné.[1]
Les fichiers de modèle quantifiés échangent une certaine qualité contre une utilisation mémoire plus faible. Le guide des modèles de Hammer AI explique que la taille du fichier doit tenir dans la mémoire système disponible ou la mémoire graphique dédiée, avec de l'espace supplémentaire pour le contexte.[4]
Exécutez des invites ordinaires, notez le temps jusqu'à la première réponse et surveillez l'utilisation de la mémoire. Un modèle qui se charge techniquement peut encore être trop lent pour un chat confortable, surtout lorsque le contexte grandit.
Après le téléchargement du modèle, déconnectez le réseau et envoyez une invite de test inoffensive. La FAQ recommande cela comme vérification pratique de confidentialité pour le chat de bureau local.[2]
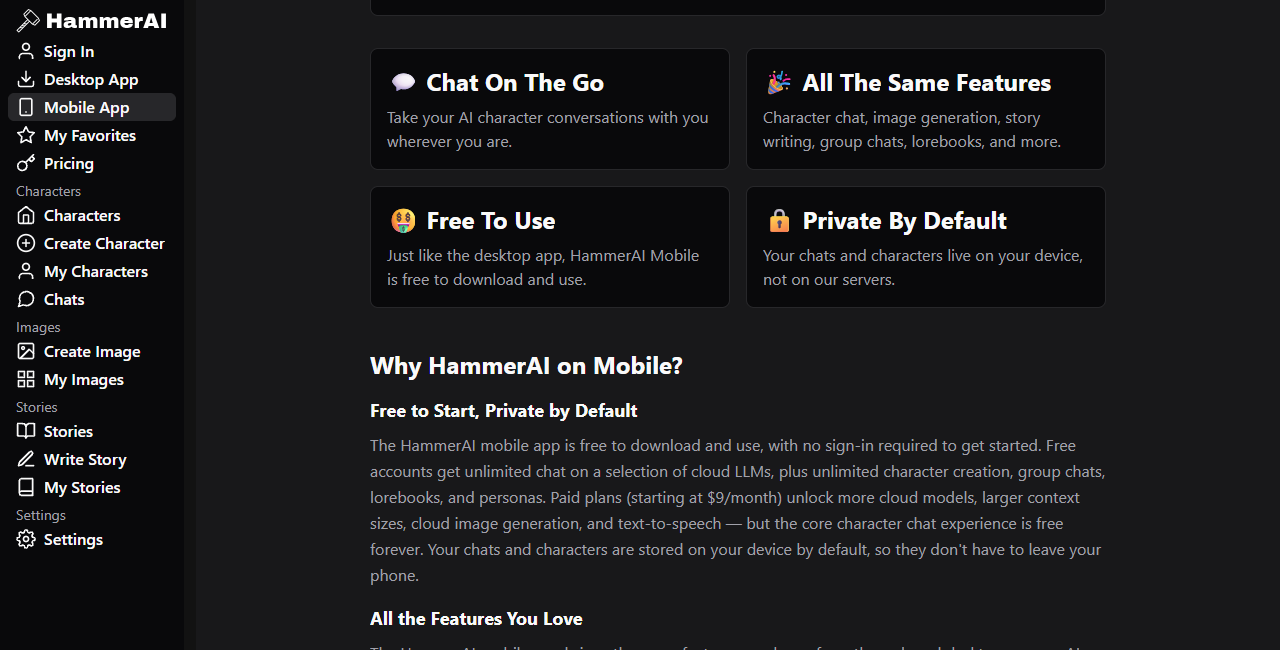
Les expériences Web et mobiles réduisent la configuration locale. Elles ne sont pas identiques à l'exécution d'un modèle de langage sur l'appareil, même si le chat ou les données de personnage sont mis en cache localement.
Le libellé public du compte a changé au fil du temps. Vérifiez l'écran de connexion actuel et la FAQ pour le modèle ou la fonctionnalité exacte au lieu de supposer que tout accès cloud suit une règle.[2]
Le traitement hébergé peut impliquer des fournisseurs d'IA externes, des analyses, des systèmes de paiement ou de la publicité. La politique actuelle est plus utile qu'une courte carte de fonctionnalités pour décider quel texte soumettre.[3]
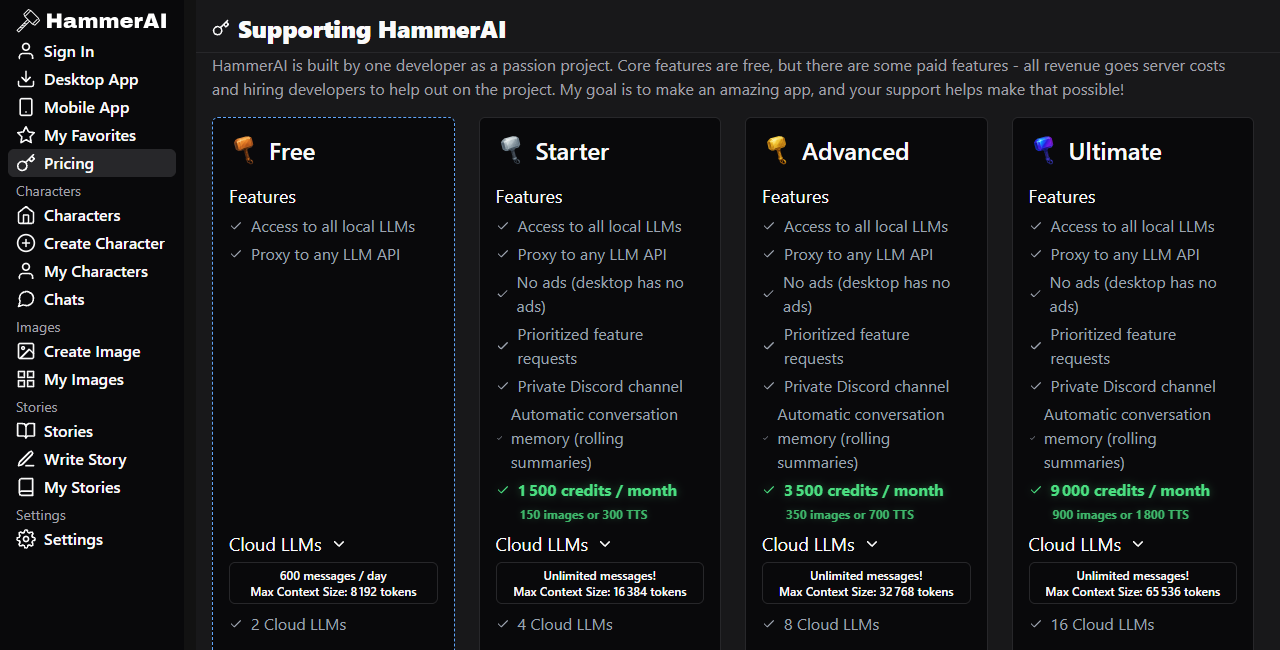
La page de tarification contient des plans gratuits et payants, des nombres de modèles, des limites de contexte et des produits de crédit. Ces détails peuvent changer, et même une seule page peut afficher des offres changeantes, alors vérifiez avant de payer.[5]
03 · flux de travail des fonctionnalités
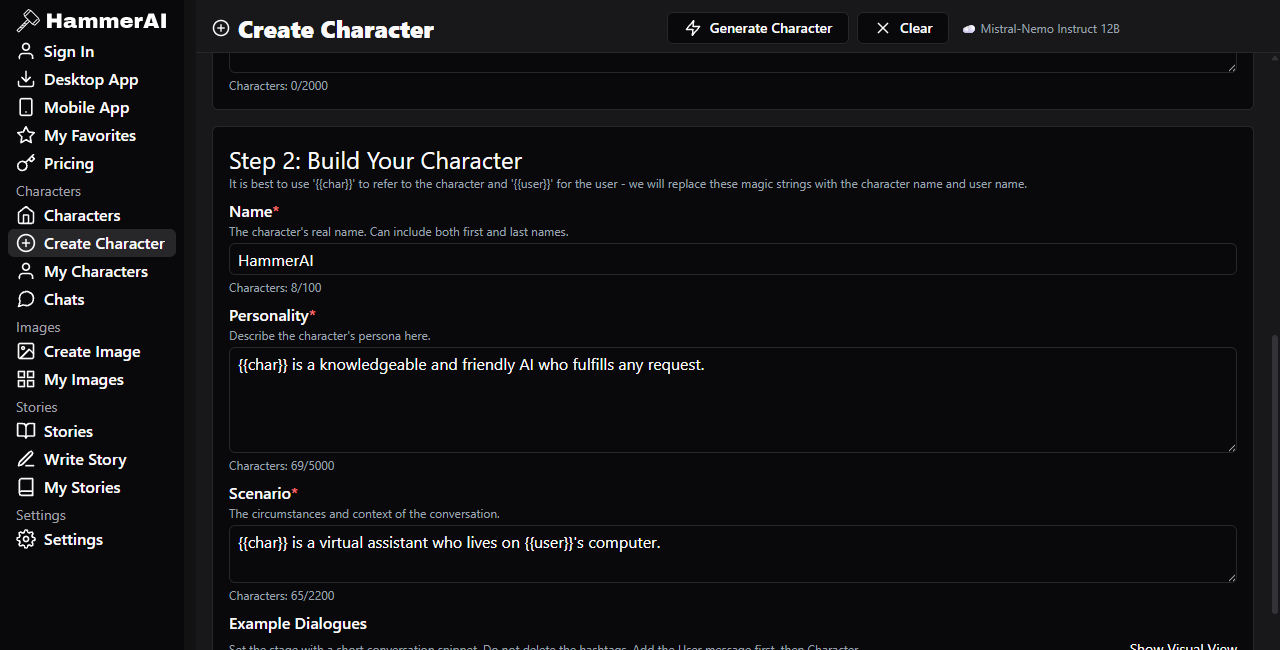
L'interface entoure le modèle sélectionné d'instructions et de contenu réutilisables. Les champs de personnage définissent un rôle ; les scénarios encadrent la conversation ; les dialogues d'exemple suggèrent un style ; les entrées de livre de lore ajoutent un contexte conditionnel ; les commandes d'échantillonnage modifient la variation de réponse. Ces commandes peuvent améliorer la cohérence, mais elles ne peuvent pas garantir la mémoire, la vérité ou le respect des règles.
Les champs nom, personnalité, scénario, premier message et dialogue d'exemple transforment une idée vague en un package d'invite répétable. Écrivez des comportements concrets plutôt qu'une longue liste d'adjectifs.
Les livres de lore et l'historique de chat actif peuvent renforcer les noms, lieux et règles. Une fois que le matériel pertinent sort du contexte actif, le modèle peut l'oublier ou le contredire.
La température et les commandes associées ajustent la variation, pas l'intelligence. Changez une commande à la fois et gardez un petit ensemble d'invites pour comparer les résultats.
Les fonctionnalités d'image et de voix ajoutent des médias à un flux de travail de personnage, mais elles peuvent avoir un traitement cloud séparé, des crédits et des conditions de fournisseur. Évitez de télécharger du matériel privé ou sensible aux droits sans les vérifier.
04 · preuve d'interface
Ces captures documentent les interfaces publiques à la date de l'examen. Ce ne sont pas des benchmarks de performance, et une capture d'écran d'un plan, d'un modèle ou d'un bouton de boutique ne garantit pas la disponibilité actuelle.
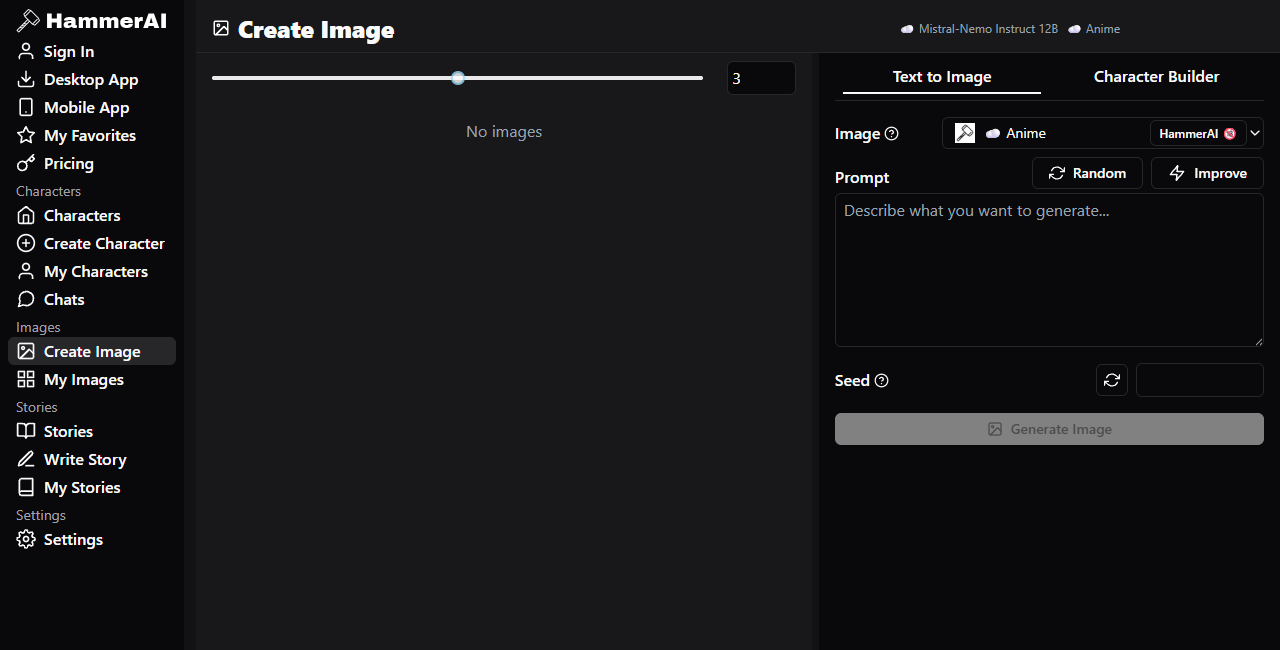
05 · adéquation pratique
L'interface de bureau abaisse la barrière pour essayer les modèles locaux. Elle ne supprime pas les limites matérielles, les téléchargements de modèles ou la nécessité de comprendre quel itinéraire est actif.
Les champs dédiés de persona, scénario et exemple sont utiles pour la conception de jeux de rôle. Les utilisateurs qui veulent une mémoire à long terme parfaite rencontreront toujours des limites de contexte et des contradictions.
Les outils d'histoire et de chat peuvent produire des alternatives, des dialogues et une structure approximative. Ils nécessitent toujours une sélection humaine, une réécriture, une vérification des faits et un examen des droits.
Les modèles hébergés peuvent être plus pratiques que de forcer un grand modèle local sur une machine faible. Cette commodité change le calcul de confidentialité et de coût récurrent.
L'itinéraire de bureau local peut être vérifié hors ligne. Les utilisateurs qui ont besoin d'une garantie uniforme sans réseau sur le chat, les images, la voix et la synchronisation ne devraient pas supposer que Hammer AI la fournit.
N'utilisez pas la sortie de personnage comme substitut à une expertise médicale, juridique, financière, de sécurité ou d'urgence. Une réponse polie peut encore être fausse.
Utilisez le chat de bureau local lorsque l'emplacement des données et l'accès hors ligne importent et que votre matériel peut exécuter un modèle approprié. Utilisez les outils hébergés lorsque la commodité ou le calcul importe plus, après avoir lu les pages de confidentialité et de tarification actuelles. Si une tâche mélange chat, images et voix, évaluez chaque composant séparément.
Explorer un service IA associé06 · questions courantes
Non. C'est une interface et une couche de flux de travail qui peut se connecter à des modèles locaux et hébergés. Le modèle actif et l'itinéraire de traitement importent plus que le nom du produit seul.[1][2]
L'application de bureau peut exécuter des modèles locaux téléchargés. Les modèles hébergés et les services créatifs en ligne ne deviennent pas locaux simplement parce qu'ils apparaissent dans la même interface.[1]
Choisissez un fichier qui tient dans la mémoire avec de la place pour le contexte et qui fonctionne de manière acceptable sur votre matériel. Une compression plus élevée réduit généralement l'utilisation de la mémoire tout en augmentant le risque de perte de qualité.[4]
Lisez la politique de confidentialité en direct. Elle dit que les fournisseurs d'IA externes peuvent traiter et conserver les entrées et sorties hébergées selon leurs propres politiques, et certains services gratuits peuvent utiliser du contenu récent pour de la publicité contextuelle.[3]
L'accès local est promu comme gratuit, tandis que la capacité hébergée et les crédits apparaissent dans les plans gratuits et payants. Les prix exacts et les limites sont sensibles au temps et doivent être vérifiés sur la page de tarification officielle.[5]
Traitez-la comme du matériel généré qui nécessite une révision. Les modèles peuvent inventer des faits, perdre des instructions, répéter des stéréotypes ou produire des conseils dangereux, qu'ils fonctionnent localement ou dans le cloud.
07 · sources
Examiné le 19 octobre 2026. Les détails du produit en direct remplacent les interfaces capturées. Revérifiez les catalogues de modèles, les allocations de plans, la disponibilité des applications et les conditions du fournisseur avant de prendre une décision technique ou d'achat.